

 (abre em nova aba)
Escrito por: Danilo Fuchs (abre em nova aba), Celso Chagas (abre em nova aba) e Isabella Bonfitto (abre em nova aba)
Introdução
Um agente de IA consulta a Salvy, orça e adiciona dados em 3 linhas só depois da confirmação do usuário.
Na Salvy, trabalhamos com ciclos de Release e Break (abre em nova aba). Durante o break de junho de 2026, chamamos nossos maiores clientes para passarem 2 dias no nosso escritório, um evento que chamamos de Compass (abre em nova aba). Conversando com esses CTOs e gerentes de TI, entendemos que a Salvy dá uma grande autonomia no gerenciamento de linhas, mas isso gera um trabalho adicional: mais decisões tomadas, acompanhamentos recorrentes, ações repetitivas.
Focamos em atacar isso em pelo menos três frentes para o release Maestro (abre em nova aba):
- Construção de um MCP
- Expansão da nossa API pública
- Possibilitar ações em massa na plataforma
A IA hoje se conecta em quase todas as ferramentas de trabalho: traz contexto, interage com serviços externos, entende bugs, implementa features. Poderíamos ter implementado um agente nosso, numa experiência de chat, mas assim não conversaríamos com o resto da operação da empresa. Queremos estar onde nosso cliente está.
Neste post, vamos contar um pouco como nossa Engenharia de Produto nos levou a esse lançamento, e o carinho que colocamos no MCP.
Por onde começamos
Antes de qualquer coisa, nós precisávamos entender o que iríamos construir. Se uma pessoa quer conectar um agente de IA na Salvy, quais são suas expectativas? Quais perguntas ela quer responder? Quais ações repetitivas ela faz no dia a dia que quer delegar para um agente? Quais os receios dela nessa conexão?
Antes de desenvolver qualquer produto novo, fazemos uma sessão de Shaping. Nossa Product Designer Isabella Bonfitto (abre em nova aba) puxou essa frente, e o trabalho pode ser resumido nesse print do doc no Notion:
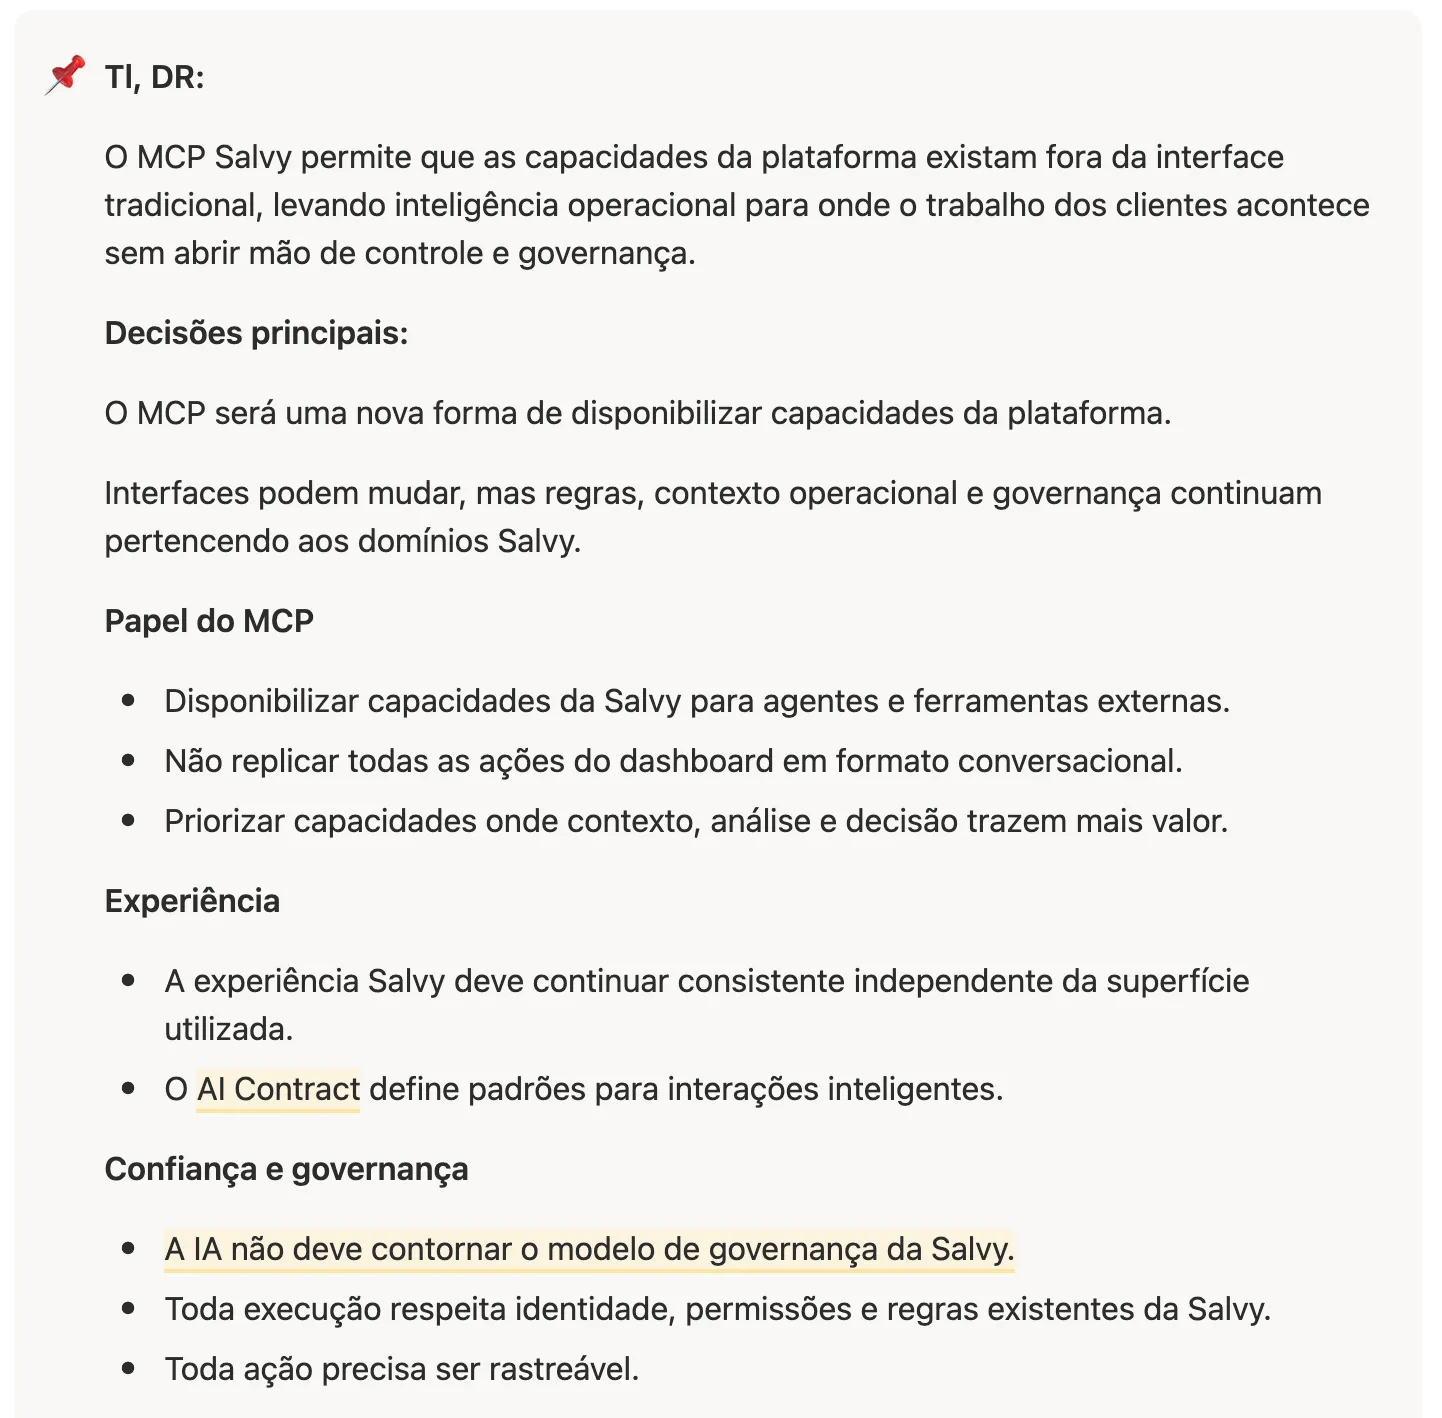
Começamos com tools de leitura para ajudar na tomada de decisão. Com o tempo, entendemos que o real poder dos agentes está quando eles combinam sua capacidade de decidir com a capacidade de executar.
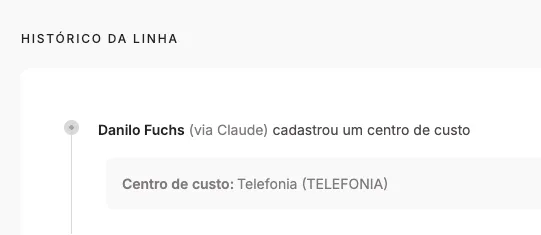
Entendemos que auditoria seria um ponto central. Toda ação feita via MCP deveria identificar quem autorizou, através de qual agente, e devemos respeitar as permissões individuais de cada usuário.
MCP não é API
Em paralelo ao MCP, outro time estava desenvolvendo a versão 3 da nossa API pública (abre em nova aba), com diversas melhorias de qualidade de vida e novos endpoints.
Naturalmente, nos questionamos se o MCP deveria ser uma réplica da API, mas entendemos que não:
MCP está mais próximo de um site, um app, uma UI, do que uma API.
Da mesma forma que um site precisa trazer contexto, priorizar informações com hierarquia visual e de narrativa, e respeitar um tom de voz, o MCP também precisa ser construído com esse cuidado. Nosso time de design já vinha nesse caminho: paramos de desenhar telas e começamos a desenhar regras (abre em nova aba), e o tom de voz da Salvy (abre em nova aba) já é publicado como um prompt pronto para IAs.
API deve atender alguém construindo automações repetitivas e previsíveis. MCP deve atender demandas maleáveis, auxiliar na tomada de decisão e guiar a descoberta do produto.
Desenhando a solução técnica
Na Salvy, escrever é uma ferramenta de pensamento: existe um tipo de pensamento que só acontece escrevendo (abre em nova aba). E não dá pra escrever bem sem ler bem (abre em nova aba), então antes das ADRs estudamos os MCPs de quem já estava na frente.
Ao todo, escrevemos 4 ADRs:
- Fundação: O que é o MCP e qual nossa filosofia para construir ele? O que não queremos implementar agora? Optamos por uma rota pragmática, que detalhamos em seguida
- Infraestrutura: Onde o servidor MCP vai rodar? Decidimos incluir ele no nosso monolito Node.js. Para facilitar uma possível separação no futuro, expomos em um subdomínio próprio
- Autenticação e Autorização: Na nossa arquitetura atual, nosso BFF tRPC no Dashboard cuida da autenticação via Clerk e autorização via scopes. Com o MCP implementado no monolito, tivemos que repensar essa arquitetura, e trazer mais responsabilidade para ele
- Distribuição: Como publicar o MCP como um Conector no Claude, Plugin no ChatGPT, Agente no Microsoft 365 Copilot? O que precisamos ter e o que não podemos ter? Como evitar surpresas lá na frente?
Escrevemos essas ADRs em dupla e discutimos com todo o time de engenharia, para disseminar conhecimento.
As pequenas grandes decisões
Desenvolver um servidor MCP parece simples. Poderíamos ter feito um prompt “Implement MCP, make no mistakes”, mas conscientemente optamos por entender cada etapa e tomar centenas de pequenas decisões. Como não estamos fazendo o primeiro MCP do mundo, podemos nos inspirar nos melhores.
Neste início, conversamos com colegas da Conta Simples (abre em nova aba) e da Resend (abre em nova aba), que tinham acabado de lançar seus MCPs em julho. Nestas conversas, conseguimos adiantar algumas dores que eles já enfrentaram, como paginação e distribuição.
Avaliando MCPs públicos
Nosso Product Engineer Celso Chagas (abre em nova aba) teve uma ideia genial: pesquisou os melhores servidores com código público, vetorizou eles usando GitNexus (abre em nova aba), e começou a fazer perguntas sobre eles com seu Claude. Abaixo, algumas das decisões que tomamos com base nesse estudo:
Qual deve ser a granularidade das nossas Tools?
Cada tool contém título, descrição e schemas. Isso ocupa espaço na janela de contexto do agente. Agentes mais modernos incluem uma meta-tool de “search_tool” nos seus harness, para contornar isso. Além disso, o nosso MCP poderia ter uma meta-tool também. Queríamos saber se fazia sentido ir por este caminho:
Dos 9 servidores que analisamos, 4 escondem a maior parte do catálogo atrás de tools genéricas (PostHog, Sentry, Cloudflare e Stripe): uma única tool genérica “run_action”, recebendo argumentos dinâmicos, e uma tool “search_action” para que o agente descubra as ações possíveis.
GitHub agrupa tools dentro de grupos, que podem ser ativados separadamente através de headers na configuração do conector.
Notion, Twilio e ElevenLabs expõem tudo de forma plana, uma tool por ação. Vercel chega a publicar mais de 200 tools por servidor.
Decidimos começar por este caminho, visto que demoraria um bom tempo para chegarmos a 200+ tools. Se isso se tornar um problema, no futuro podemos mover para tools genéricas, como fez o PostHog (abre em nova aba).
Outro motivador para essa decisão foi o seguinte raciocínio: se a janela de contexto das tools for um problema para 1 servidor com 100 tools, seria um problema muito maior com 50 servidores de 3 tools cada. Se na Salvy, com 40 pessoas em 2026, já temos 52 MCPs conectados no Claude, o problema de descoberta de ferramentas será com certeza solucionado no futuro pela especificação MCP e/ou pelos harness dos agentes.
Operações em massa
Atendemos clientes com milhares de linhas corporativas, com operações extremamente dinâmicas. É necessário suportar operações em massa, como pedido de várias linhas, troca de plano, dados adicionais e cancelamento.
Se um cancelamento demora 15 segundos para processar, nossa tool não pode demorar 1500 segundos para processar 100 linhas. Partimos para um modelo de processamento assíncrono:
Cada operação em massa vira uma Task. Essa task guarda os IDs dos Jobs que irão efetuar a ação eventual, e o agente recebe um ID desta task, e é orientado a fazer polling de uma tool get_task até completar com sucesso ou falha parcial.
No futuro, gostaríamos de suportar as tasks oficiais do MCP (abre em nova aba) e utilizar MCP Events (abre em nova aba) para notificar a conclusão via webhooks, mas por enquanto ainda não são suportadas pelo Claude, por exemplo.
Outras decisões
A pesquisa também guiou duas decisões que aparecem mais à frente: o formato das descrições das tools e como coletar feedback dos agentes.
Arquitetura evolutiva
Logo começamos uma PoC no nosso monolito. Adicionamos as dependências necessárias, apontamos um subdomínio mcp.salvy.com.br (abre em nova aba) e expomos uma tool hello_world, com autenticação por uma chave de API interna. Adicionamos também uma feature flag capaz de ligar ou desligar o MCP completamente para usuários externos.
Assim, no mesmo dia já conseguimos iterar em produção, sem risco algum de expor algo inacabado para clientes. Testamos conexão em diferentes agentes, exploramos ideias novas, e fomos adicionando camadas em cima dessa base.
A cada semana, definimos as “tools da semana”. Analisamos quais gaps existiam na arquitetura para suportar aquele caso de uso e atacamos eles incrementalmente. Focamos em abordar elas ao longo de agosto e setembro.
No meio do caminho, enxergamos que era necessária uma estrutura robusta de autorização: um usuário no dashboard da Salvy pode ter acesso a N empresas, cada uma com um perfil de acesso diferente, e M organizações, que por si só contêm J outras empresas. Além disso, queríamos suportar conexão via chave de API, num modelo transparente.
Definimos essa estrutura com o Hudo (abre em nova aba), nosso CTO. Utilizamos Async Local Storage e uma estrutura de Principal + Identity para podermos validar permissões em qualquer nível da arquitetura, em um formato reutilizável na aplicação inteira.
Em poucas semanas, já tínhamos a base pronta:
export default registerMcpTool({
  name: "add_data_to_phone_accounts",
  description: `...`,
  // Escopos de acesso para usuário e chave de API
  scopes: ["phone-account:top-up"],
  // Autorização declarativa
  authorization: [
    { company: (input) => uuid(input.companyId) },
    {
      resources: {
        of: phoneAccountResource,
        ids: (input) => input.phoneAccountIds?.map(uuid) ?? [],
      },
    },
  ],
  // Tags que afetam as annotations
  kind: "write",
  effects: ["billable"],
  idempotent: false,
  // Schemas Zod, declarados em outros arquivos
  inputSchema: addDataToPhoneAccountsInputSchema,
  outputSchema: addDataToPhoneAccountsResponseSchema,
  // Handler
  run: async ({ input, ctx }) => {
    // Contexto de injeção de dependências
    const result = await ctx.container.get(AddDataToPhoneAccounts).run({
      // inputs
    });

    return { structured: result }; // Output estruturado ou textual (.md)
  },
});
O usuário agora é outro
Em uma interface convencional, tomamos todo o cuidado para traduzir uma regra de negócio visualmente, para não trazer para o usuário uma informação errada ou confusa. Quando uma ação tem impacto financeiro, por exemplo, indicamos com clareza com modais de confirmação e valores calculados:
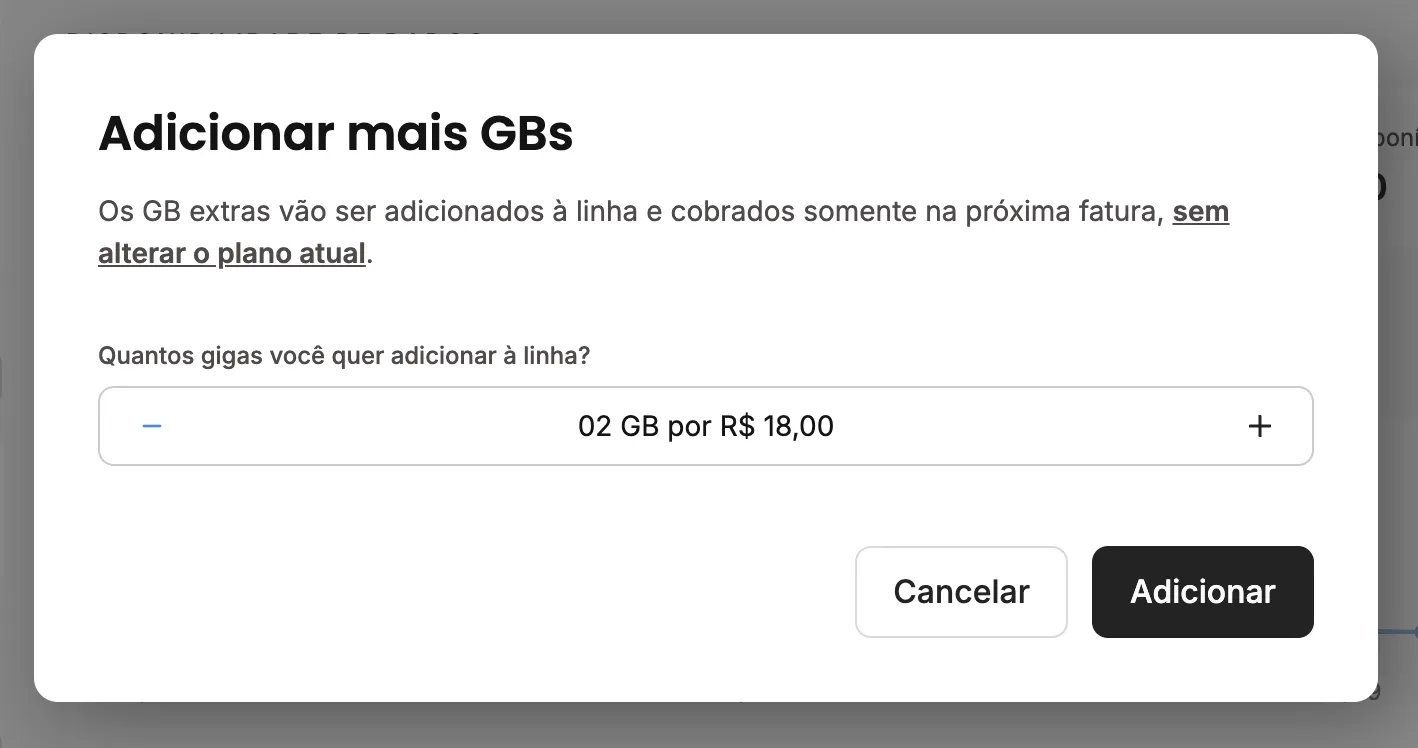
Como garantir essa clareza para um usuário usando um agente, que só vê texto?
Pensamos bastante sobre isso, pesquisamos nos MCPs públicos e identificamos 5 práticas que melhoram a confiabilidade e transparência das tools: Descrições ricas, Evitar códigos técnicos, Schemas em inputs e outputs, Anotações, e Orçamentos.
Tools com descrições ricas das regras de negócio: Incluímos informações ricas sobre o impacto daquela ação, como utilizar e como simular elas para que o usuário seja informado. Chegamos num template padrão que aplicamos em todas as tools:
One imperative sentence saying what the tool does, ending in a period.

<examples>
list_phone_accounts(companyId: "0f9c…")
list_phone_accounts(companyId: "0f9c…", productTypes: ["mobile"], page: 2)
</examples>

<hints>
- what has to be called first, and where each id comes from
- when to use a sibling tool instead of this one
- defaults that are not obvious, and why they are the default
</hints>

<format>
- how the text the agent writes has to come out, when a human reads it
</format>- A primeira linha decide o roteamento: uma frase no imperativo, com menos de 120 caracteres. Alguns harness truncam o resto na lista de tools antes de passar pra um agente.
<examples>é obrigatório: pelo menos uma chamada de exemplo.<format>é opcional: adicionamos quando o input é texto livre, como osubmit_mcp_feedback.- Teto de 2048 caracteres: limite atual do Claude Code.
Escrevemos regras customizadas no oxlint, testes automatizados e regras .claude/rules para garantir que toda descrição siga esse padrão.
Evitar expor códigos internos: Se um agente recebe em um output o código de erro “DONOR_CNPJ_MISMATCH”, ele provavelmente vai ecoar ele para o usuário. Ao invés de expor essa complexidade, traduzimos para um texto puro: “O CNPJ informado no pedido não é o mesmo da linha na operadora atual. Fale com o suporte para corrigir esses dados.”
Descrição nos schemas de input e output: Todos os campos de entrada precisam de descrições textuais no seu JSON Schema. Para as saídas JSON, todos os campos também precisam ser descritos. Declaramos eles em Zod.
Tool annotations: O MCP permite indicar para um agente se uma operação é somente-leitura, se é idempotente, se é destrutiva ou se pode trazer informações do mundo externo. Todas nossas tools declaram esses metadados através de uma interpretação nossa, que nos permite conectar middlewares de autorização e idempotência declarativamente:
{
  kind: "write",
  effects: ["billable"],
  idempotent: false,
}
Devolver “orçamentos” para tools que têm impacto financeiro: Ao invés de executar a operação imediatamente, retornamos um orçamento: os itens cobrados, um digest das linhas selecionadas e uma chave de idempotência. O agente é instruído a informar o usuário e pedir confirmação, e então chamar a mesma tool devolvendo esses três valores sem alteração.
Skills e tool de aprendizagem: Um próximo passo que queremos implementar é uma tool de aprendizado: um agente pede documentação de um tópico e retornamos um texto em markdown, e distribuição de skills via MCP (abre em nova aba).
Na prática
Um exemplo de tool que compra um pacote de dados adicionais em várias linhas é a add_data_to_phone_accounts:
Anotações
O que o agente recebe no tools/list, ao lado do nome:
{
  "name": "add_data_to_phone_accounts",
  "annotations": {
    "readOnlyHint": false,
    "destructiveHint": true,
    "idempotentHint": false
  }
}
Descrição
Add mobile data to a company's phone accounts, quoting the cost before charging anything.

<examples>
add_data_to_phone_accounts(companyId: "0f9c…", phoneAccountIds: ["3b71…"], quantityGB: 5)
add_data_to_phone_accounts(companyId: "0f9c…", filters: { groupIds: ["4c8a…"] }, quantityGB: 5)
add_data_to_phone_accounts(companyId: "0f9c…", phoneAccountIds: ["3b71…"], quantityGB: 5, confirmation: { charges: [{ kind: "one-off", amountCents: 4500 }], selectionDigest: "9ab3…", idempotencyKey: "7c11…" })
</examples>

<hints>
- Two steps, first one free. Without `confirmation` you get per-phone-account costs and
  `charges` and nothing is written. Show the user what it costs, then call again
  with the three values verbatim, the key included — reusing it is what keeps a
  retry from charging twice.
- Not reversible. The gigabytes reach the carrier at once and cannot be taken back;
  the cost lands on the next invoice. Ask before the second call, never after.
- Say which phone accounts with `phoneAccountIds` or `filters`, never both. A filter needs
  at least one field; for the whole company spell out `allActivePhoneAccounts: true`.
- Filters take active phone accounts only. `skippedInactiveCount` says how many they left
  out — tell the user, or they will think the whole group went through.
- All or nothing when quoting: one named id that cannot receive data fails the
  quote and lists the offenders. Fix them and quote again; nothing was written.
- `companyId` from `list_companies`, ids and filter values from
  `list_phone_accounts`. Never guess a UUID.
- Repeating is how you finish a call that broke halfway: resend the same
  `confirmation` and phone accounts already served come back `already-applied`, not
  charged twice. Do **not** narrow the selection and quote again — a new quote
  charges those phone accounts a second time.
- Read `get_phone_account_usage` first when asked who needs data. This tool only
  writes; it says nothing about what a phone account used or has left.
</hints>
Input
Todos os inputs são declarados em Zod, que converte para JSON Schema. Para melhor visualização aqui, os inputs seriam assim se fossem escritos em TypeScript:
type UUID = string;

type Input = {
  companyId: UUID;
  /**
   * At most 25 per call, counted as sent: a repeated id still takes a slot even
   * though it is collapsed. For more than that, split across calls — each one is
   * quoted, confirmed and applied on its own, so a later failure does not undo
   * an earlier call.
   *
   * @minItems 1
   * @maxItems 25
   */
  phoneAccountIds?: UUID[];
  /**
   * Only ever active phone accounts. An unknown field is rejected rather than
   * ignored, so a misspelled filter cannot quietly become "the whole company". A
   * filter selecting more than 25 phone accounts is refused rather than trimmed,
   * so narrow it or name ids.
   *
   * @additionalProperties false
   */
  filters?: {
    /**
     * Group ids from a row's `group` in `list_phone_accounts`, to top up the phone
     * accounts filed under them.
     *
     * @minItems 1
     */
    groupIds?: UUID[];
    /**
     * Plan ids from a row's `subscriptionPlan.id` in `list_phone_accounts`.
     *
     * @minItems 1
     */
    subscriptionPlanIds?: UUID[];
    /**
     * Matched against the company's registered cost centers by code or name,
     * ignoring case, surrounding spaces and accents; a label carrying both, such
     * as `ENG - Engenharia`, matches either part. A name matching nothing selects
     * nothing. The literal `"__null__"` selects every active phone account with no
     * cost center, which is a large and easily unintended selection — read the
     * quote before confirming it.
     *
     * @minItems 1
     */
    costCenters?: string[];
    /**
     * Defaults to every type the company holds. `mobile` is a mobile phone
     * account, which is what "linha" usually means.
     *
     * @minItems 1
     */
    productTypes?: Array<"mobile" | "mobile-did" | "landline-did" | "global">;
    /**
     * Every active phone account of the company.
     */
    allActivePhoneAccounts?: true;
  };
  /**
   * Gigabytes to add to each phone account, so the total is this times the
   * number of phone accounts. At most 10 per call, and whole numbers only —
   * carriers sell top-ups in fixed sizes and compose them, so a fraction has no
   * valid combination.
   *
   * @integer
   * @minimum 1
   * @maximum 10
   */
  quantityGB: number;
  /**
   * Omit to get the quote. Pass the values from that quote back unchanged to add
   * the data. Charges or a digest that no longer describe the call are refused.
   */
  confirmation?: {
    /**
     * `selectionDigest` from the quote, unchanged. It identifies what the quote
     * covered.
     *
     * @minLength 1
     */
    selectionDigest: string;
    /**
     * `idempotencyKey` from the quote, unchanged. It is what makes a retry safe,
     * and nothing verifies it — a different key is a different intent and charges
     * again, so **reuse it** to retry or to finish a call that broke halfway.
     * Quote again only when you mean to spend a second time on purpose.
     *
     * @minLength 1
     */
    idempotencyKey: string;
    /**
     * `charges` from the quote, unchanged. Each one is a ceiling: if a price rose
     * since the quote the call is refused and the error carries the new charges,
     * and if a target dropped out the bill is simply lower.
     *
     * @minItems 1
     */
    charges: Array<{
      kind: "one-off";
      /**
       * @integer
       * @minimum 0
       */
      amountCents: number;
    }>;
  };

  // Every Salvy tool also takes these, for analytics
  /**
   * In 15-25 words and in the third person, why you are calling this tool and
   * what the user is trying to get done. Recorded for analytics only — nobody
   * reads it back to you or to the user, and it changes nothing about the call.
   *
   * Never put personal or customer data here: no phone numbers, ICCIDs, CNPJs,
   * CPFs, e-mails, or names of people or companies. Write "a company", "an
   * employee", "a line" instead. Example: "Checking a line's data usage to
   * explain a charge the customer is questioning."
   */
  context?: string;
  /**
   * The exact model identifier you are running as, as your system prompt or
   * environment states it — for example `claude-opus-5` or `gpt-5.2`. Analytics
   * only, and unverified: the same tool reads differently to different models,
   * and this is what tells us whether a description misleads everyone or only
   * you. Omit it if you do not know it with certainty — never guess.
   */
  llmModel?: string;
  /**
   * The `conversationId` from this server's previous answer in this
   * conversation, echoed back unchanged. The first answer carries one; omit it
   * only on your first call. Never invent one, and hold parallel calls until the
   * first answer has given it to you.
   */
  conversationId?: string;
};
Output
type UUID = string;

type Output = {
  /**
   * `false` means this was a quote and nothing happened. `true` means the call
   * ran; read `phoneAccounts` for what each phone account got.
   */
  applied: boolean;
  /**
   * Gigabytes added per phone account, not across the call.
   */
  quantityGB: number;
  /**
   * What the quote covered, echoed unchanged on an apply. A top-up has a single
   * `one-off` charge. Not what this call spent — a repeat that finds every phone
   * account already served echoes the same charges and spends nothing.
   */
  charges: Array<{
    kind: "one-off";
    /**
     * @integer
     * @minimum 0
     */
    amountCents: number;
  }>;
  /**
   * What this call actually spent: the sum over `phoneAccounts` marked
   * `applied`. Report this to the user, never `charges`.
   */
  chargedCents: number;
  /**
   * Pass back in `confirmation` to apply this exact quote.
   */
  selectionDigest: string;
  /**
   * Generated for you so you have a stable key to pass back in `confirmation`.
   * Reuse the same one to retry; a different key is a different intent and
   * charges again.
   */
  idempotencyKey: string;
  /**
   * How many phone accounts received data on this call.
   */
  appliedCount: number;
  /**
   * One entry per selected phone account, in the order the ids were passed —
   * first occurrence, since a repeated id is collapsed and gets a single entry,
   * so `phoneAccounts` can be shorter than the ids you sent. With `filters`, the
   * order the selection resolved in.
   */
  phoneAccounts: Array<{
    phoneAccountId: UUID;
    /**
     * `null` for a phone account that has no number yet, which happens while it is
     * still being provisioned.
     */
    phoneNumber: string | null;
    /**
     * What this phone account costs: `quantityGB` times its own price per
     * gigabyte. Phone accounts on different plans do not necessarily cost the
     * same.
     */
    costCents: number;
    /**
     * `quoted` on a quote. On an apply: `applied` for data added now,
     * `already-applied` for a phone account this quote had already served, and
     * `failed` for one that did not go through — which means *not confirmed*, not
     * *not granted*. A `failed` phone account may have received the gigabytes and
     * failed afterwards, so resend the same `confirmation` rather than assuming it
     * got nothing.
     */
    status: "quoted" | "applied" | "already-applied" | "failed";
    /**
     * Why a phone account did not go through, in Portuguese, ready to show the
     * user. `null` for every other status.
     */
    reason: string | null;
  }>;
  /**
   * How many phone accounts the filter matched and left out for not being
   * active. Zero when ids were named, because those fail the call instead.
   */
  skippedInactiveCount: number;

  // Every Salvy tool answer also carries this
  /**
   * Echo this back as `conversationId` on your next call to this server.
   */
  conversationId?: string;
};
Ouvindo um usuário que não fala com você
Na Engenharia de Produto, não se decide nada sem se colocar nos pés do usuário. Afinal, um produto só faz sentido se ele resolve a dor de alguém. E descobrir qual é essa dor não é fácil: na maioria das vezes o usuário nem sabe descrevê-la, e é nosso trabalho extraí-la.
Na Salvy, temos um contato muito próximo com nossos clientes. Envolvemos eles desde a primeira concepção da ideia, iteramos em betas fechados e coletamos feedbacks diretos. Durante o desenvolvimento, Product Designers e Product Engineers conversam constantemente com os clientes, sem intermediários.
Como fazer isso quando seu usuário é, em partes, uma máquina?
Seu cliente ainda está lá
Nunca deixamos e não deixaremos de conversar com os clientes, humanos na ponta. Apresentamos o produto para várias empresas, assistimos a configuração do agente de IA, observamos as perguntas feitas.
Foi assim que nasceu nossa primeira tool de escrita, que nem estava no mapa: em 05/08, numa entrevista sobre a nova funcionalidade de Grupos de Linhas no dashboard, um cliente contou que, conforme a operação cresce, criar grupos manualmente vira um trabalhão: precisa selecionar pessoa por pessoa numa lista e mover individualmente. Ao mesmo tempo, todo o conhecimento sobre quem é quem no parque de linhas vive na cabeça de uma ou duas pessoas.
O Celso, que estava na conversa, viu ali um trabalho perfeito para um agente: “crie um grupo com o administrativo”. Dois dias depois, a create_phone_account_group estava em produção.
Selecionamos 5 empresas-chave para um beta fechado, cada uma num nível de maturidade diferente em relação à IA e operação, liberamos o acesso para cada uma por feature flag e passamos a iterar com o cliente no ciclo.
Tool de feedback
Uma das ideias que surgiram da pesquisa exploratória é adicionar uma tool submit_mcp_feedback, que um agente pode chamar a qualquer momento para avisar o time da Salvy sobre uma dessas coisas:
- Resposta errada
- Descrição inadequada
- Schema de entrada confuso ou errado
- Formato da resposta confuso ou errado
- Tool faltando
- Mensagem de erro inesperada
- Performance
- Outro
Nas instruções gerais do servidor, mencionamos essa tool para aumentar as chances do agente carregar ela no seu contexto:
If one of them gets in your way — missing, wrong answer, misleading description,
useless error — report it with `submit_mcp_feedback` in the same turn,
even if you worked around it.

Then carry on with the user's request: the report answers nothing for them.
Chegamos nisso com base no estudo dos MCPs de código aberto.
Cada feedback é sanitizado, removemos qualquer identificador pessoal e publicamos em um canal #mcp-feedbacks, para dar visibilidade para o time e para tomarmos ação o mais rápido possível. Muitas vezes, basta mencionar @Claude nesta thread para implementar a solução na hora.
Um desses feedbacks nos levou a construir uma tool de Timeline de auditoria, para que um agente possa responder perguntas como “Quem bloqueou essa linha e quando?”. No dia do release, um feedback nos ajudou a aprimorar o conceito de “linha sem uso” (abre em nova aba), baseado nos diferentes planos e produtos da Salvy.
No fim, isso nos permite coletar feedback muito mais rápido do que em uma UI tradicional, já que nem sempre um humano topa conversar sobre detalhes que o incomodam levemente.
Peça contexto para a IA
A tool de feedback só nos avisa quando algo deu errado. Como saber o que está dando certo?
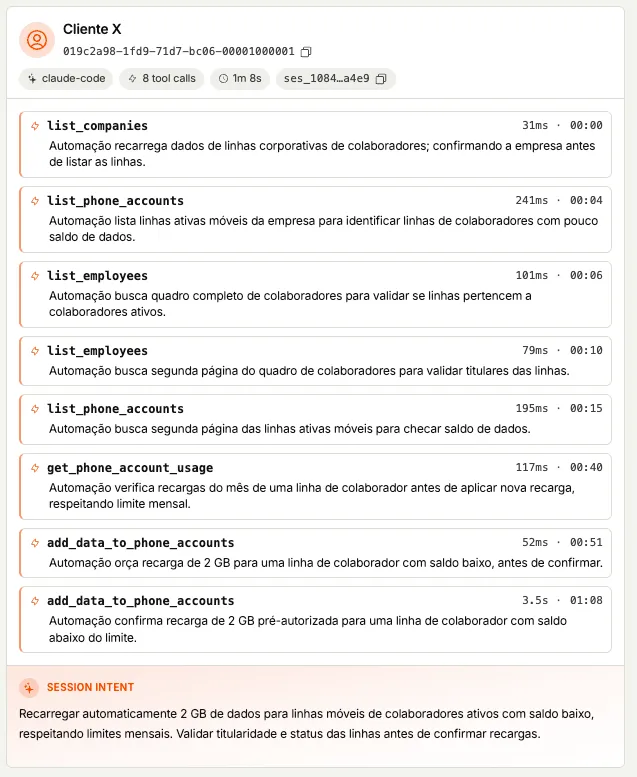
Nos inspiramos na solução do PostHog e adicionamos alguns campos opcionais em todas as tools:
- context: O agente declara em uma pequena frase o objetivo daquela chamada. Sem nenhum identificador pessoal.
- llmModel: O agente declara que modelo ele é (ex: claude-opus-5-5). Isso nos ajuda a otimizar a estrutura do MCP de acordo com os agentes que os usuários de fato utilizam. Infelizmente a spec não traz isso como metadado, então precisa ser input do próprio agente e pode haver alucinações.
- conversationId: Desde que a spec do MCP virou stateless, cada chamada de função é completamente isolada da outra. Se um usuário tem mais de um agente trabalhando em paralelo, não temos como ter certeza se há relação entre um
list_phone_accountse umadd_data_to_phone_accountschamados dentro de alguns minutos. A lógica é a seguinte: na primeira chamada MCP que um agente não enviar conversationId, geramos um UUID e retornamos no output, para ele ecoar na próxima chamada. Salvamos esse ID ao lado de outros metadados.
Ligamos estes campos ao PostHog MCP Analytics (abre em nova aba) para agregar as várias chamadas de ferramenta de uma sessão, ou de várias sessões, e interpretamos quais as intenções dos nossos usuários:
Os eventos são replicados também no nosso Metabase, onde podemos correlacionar padrões de uso com o ID do cliente, enriquecendo análises com o ramo da empresa e tamanho da operação, por exemplo.
Onde tropeçamos?
Desenvolver este produto teve seus desafios, e nem sempre acertamos. Abaixo, algumas das coisas em que engasgamos:
Dificuldade de testar internamente (dogfooding): Um analista de atendimento conhece muito mais sobre a Salvy e pode efetuar operações muito mais poderosas do que um cliente, então o MCP não bate com o seu perfil de uso. Além disso, nossos agentes Claude têm acesso ao Data Warehouse, Logs, etc. e acabam desviando do MCP durante testes.
Identificar padrões de uso antes do lançamento: O beta fechado estimulou casos de uso limitados. Após o release, diversos feedbacks surgiram de fluxos que não tínhamos previsto, ou edge cases que não eram tratados. Neste ponto somos pragmáticos: não queremos que o MCP funcione para 100% dos clientes no dia 1. Queremos lançar algo que resolve dores reais, e sentir quais as próximas dores são mais latentes para ampliarmos o produto.
Ícones no Claude e GPT: A spec MCP prevê um campo de ícone para identificar um servidor, mas nem Claude nem GPT respeitam ele. Tentamos várias alternativas, mas a única coisa que solucionou foi passar pelo processo de revisão para nos tornarmos plugins oficiais nas lojas de cada um. Até lá, nosso conector tinha uma logo genérica:

As pessoas sabem o que é um MCP? Tivemos um trabalho importante de ensinamento dos times de relacionamento (Vendas, Customer Success, Customer Experience) para que eles possam ensinar os clientes sobre MCP. Alguns clientes ainda não utilizam IA ou não têm planos compatíveis com MCP.
Notas para o futuro
Daqui para frente, imaginamos que o MCP seja uma das principais formas de se interagir com a Salvy. Construímos essa base, mas todos os engenheiros são responsáveis por manter e evoluir ela.
Porém, sabemos que este texto é um registro histórico e em pouco tempo as decisões que tomamos devem estar defasadas. Durante o desenvolvimento, a indústria se mexeu. Como é tudo muito recente e volátil, precisamos iterar rápido:
- A revisão
2026-07-28da especificação MCP foi publicada durante a implementação. Sabendo que ela viria em breve, já baseamos a solução na spec que viria. - Surgiram agentes compartilhados e com identidade própria, como o Claude Tag. Para darmos suporte, tínhamos que permitir acesso via chave de API, não só via OAuth individual.
- A spec passou a recomendar CIMD ao invés de DCR para registro de clients OAuth, levando a reconsiderações no fluxo de autenticação e coleta de metadados, alterando nossa integração com Clerk.
- Slack adicionou suporte para MCP no seu agente Slackbot.
- Mais recentemente, o ChatGPT adicionou suporte para MCP Events, permitindo que um MCP acorde um agente quando um evento ocorre.
Em breve, todos esses termos podem se tornar tão nostálgicos como Java Swing e Code::Blocks. Por isso, a cultura de engenharia da Salvy é mais importante do que o processo que praticamos e a tecnologia que usamos. Neste post, gostaríamos de expor um pouco a forma como abordamos os problemas, como pensamos no usuário, como somos pragmáticos e evolutivos, e como não temos medo algum de deploy na sexta.
Trabalhe com a gente
Se você chegou até aqui, provavelmente gosta do mesmo tipo de problema que a gente: entender o usuário, mesmo quando ele é um agente, escrever antes de codar e colocar em produção desde o primeiro dia.
Procuramos pessoas que elevem a barra, sejam curiosas e builders. Veja as nossas vagas em salvy.com.br/carreiras (abre em nova aba).